En la segunda entrega de la serie Open Data, mostramos cómo calcular los z-scores y cómo utilizarlos para comparar jugadores en distintos grupos de métricas físicas.
En esta tercera parte, damos un paso más en el análisis al incorporar datos de carreras sin balón (OBR) y de pase de nuestra suite Game Intelligence para crear perfiles de delanteros.
De nuevo, utilizaremos nuestra publicación abierta de datos de la A-League australiana 2024/25, que ahora se ha actualizado para incluir los agregados de OBR y de pase.
Partiendo del código de la segunda parte, el primer paso es combinar estos nuevos conjuntos de datos con los datos físicos agregados que ya hemos utilizado para crear un único dataframe.
1 - Combinación de conjuntos de datos
A medida que amplías el alcance de los datos con los que quieres trabajar, es completamente normal extraer y combinar información de múltiples fuentes o tablas.
Para ello, primero debemos identificar las columnas que sirven como identificadores únicos de cada registro. En nuestro caso, serán: player_id, team_id, position_group y competition_edition_id.
# Instalar librerías
import pandas as pd
import matplotlib.pyplot as plt
import numpy as np

# Localizar la fuente
url1 = "https://raw.githubusercontent.com/SkillCorner/opendata/master/data/aggregates/aus1league_physicalaggregates_20242025.csv"
url2 ="https://raw.githubusercontent.com/SkillCorner/opendata/master/data/aggregates/aus1league_obraggregates_20242025.csv"
url3 ="https://raw.githubusercontent.com/SkillCorner/opendata/master/data/aggregates/aus1league_passingaggregates_20242025.csv"

# Cargar los dataframes a partir de la URL
df_physical = pd.read_csv(url1)
df_obr = pd.read_csv(url2)
df_passing = pd.read_csv(url3)

# Comprobar un dataframe de ejemplo
df_obr.head()

# Comprobar el número de jugadores únicos en el dataframe
df_obr['player_name'].nunique()
Ahora que hemos cargado los tres dataframes directamente desde el repositorio Open Data de GitHub, el siguiente paso es combinarlos en un único dataframe. Así obtenemos un conjunto de datos unificado que reúne las métricas físicas, de OBR y de pase.
# Combinar los dataframes
df_merged = pd.merge(df_physical, df_obr, on=['player_id', 'team_id', 'position_group', 'competition_edition_id'], how='left', suffixes=('_physical', '_obr'))
df_merged = pd.merge(df_merged, df_passing, on=['player_id', 'team_id', 'position_group', 'competition_edition_id'], how='left', suffixes=('', '_passing'))
df_merged

# Mostrar las 5 primeras filas de df_merged
df_merged.head()

# Validar la combinación comprobando de nuevo los nombres de jugadores únicos
df_merged['player_name'].nunique()
Tras combinarlos, disponemos de un conjunto de datos más completo, con una amplia variedad de columnas que pueden utilizarse de forma individual para clasificar a los jugadores o de forma conjunta para crear perfiles posicionales o arquetipos sencillos.
Como punto de partida, puedes ejecutar el siguiente comando para obtener la lista completa de métricas disponibles.
list(df_merged.columns.unique())
2 - Filtrado
Ahora que estamos más familiarizados con las columnas y métricas disponibles en el conjunto de datos, casi estamos listos para empezar a combinar las variables relevantes para cada arquetipo.
Sin embargo, antes de hacerlo, primero tenemos que filtrar por grupo posicional. También conviene señalar que aumentamos el umbral de partidos de los cinco utilizados en nuestro análisis anterior a ocho, ya que esta es nuestra práctica habitual cuando incorporamos datos de Game Intelligence.
# Filtrar jugadores con al menos 8 partidos
df_filtered = df_merged[df_merged['count_match'] >= 8].copy()

# Filtrar por position_group = 'Center Forward'
df_filtered = df_filtered[df_filtered['position_group'] == 'Center Forward'].copy()

# Ejemplo de normalización por 90 minutos
df_filtered['hi_count_p90'] = (df_filtered['hi_count_full_all'] / df_filtered['minutes_full_all']) * 90
Nota: Los datos físicos todavía deben normalizarse, algo que explicamos con más detalle en la primera entrega de esta serie. Los datos de OBR y de pase ya están agregados por cada 30 minutos de posesión del equipo (P30 TIP).
A continuación, vamos a crear un nuevo dataframe que contenga únicamente las métricas que necesitamos para construir nuestros perfiles.
# Seleccionar manualmente las métricas para nuestro nuevo dataframe, df_archetype
df_archetype = df_filtered[['player_id', 'player_name', 'player_short_name', 'position_group', 'player_birthdate', 'team_name','psv99', 'hi_count_p90', 'timetosprint_top3', 'behindrun_count_p30tip', 'crossreceiverrun_count_p30tip',
 'comingshortrun_count_p30tip', 'aheadoftheballrun_count_p30tip',
'behindrun_count_dangerous_received_p30tip',            'crossreceiverrun_count_dangerous_received_p30tip', 'aheadoftheballrun_count_dangerous_received_p30tip',                          'pass_count_quickpass_attempted_p30tip', 'pass_count_linebreak_attempted_p30tip','pass_count_dangerous_attempted_p30tip',                         'crossreceiverrun_count_shotwithin10s_p30tip']]

# Comprobar las cinco primeras filas
df_archetype.head()

# Comprobar las columnas
df_archetype.columns.unique()
3 - Definición de grupos de métricas y cálculo de puntuaciones z
Con los datos preparados, ya podemos aplicar la función de z-score presentada en la segunda parte de la serie. En esta ocasión trabajamos con un conjunto de variables más amplio, lo que nos permite combinar métricas físicas, de OBR y de pase en perfiles más específicos.
En este ejemplo, crearemos tres perfiles sencillos de delantero: Delantero directo, delantero asociativo y delantero de referencia.
# --- 3. FUNCIÓN DE PUNTUACIÓN Z COMPUESTA ---
def calculate_composite_zscores(df, metrics_group1, metrics_group2, metrics_group3,
                               name_g1='direct', name_g2='linkup', name_g3='target'):
   """
   Calculates composite Z-scores for 3 groups.
   """
   df_result = df.copy()

   # --- GRUPO 1
   # Añadir skipna=True garantiza que, si a un jugador le falta 1 de las 5 métricas,
   # la media se siga calculando con las 4 restantes.
   raw_avg_g1 = ((df[metrics_group1] - df[metrics_group1].mean()) / df[metrics_group1].std()).mean(axis=1, skipna=True)
   df_result[name_g1] = (raw_avg_g1 - raw_avg_g1.mean()) / raw_avg_g1.std()

   # --- GRUPO 2
   raw_avg_g2 = ((df[metrics_group2] - df[metrics_group2].mean()) / df[metrics_group2].std()).mean(axis=1, skipna=True)
   df_result[name_g2] = (raw_avg_g2 - raw_avg_g2.mean()) / raw_avg_g2.std()

   # --- GRUPO 3
   raw_avg_g3 = ((df[metrics_group3] - df[metrics_group3].mean()) / df[metrics_group3].std()).mean(axis=1, skipna=True)
   df_result[name_g3] = (raw_avg_g3 - raw_avg_g3.mean()) / raw_avg_g3.std()

   return df_result

# --- 4. EJECUTAR LOS CÁLCULOS ---
# Definir los nuevos grupos de arquetipos
direct_metrics = ['hi_count_p90', 'psv99', 'behindrun_count_p30tip',
                 'aheadoftheballrun_count_p30tip', 'behindrun_count_dangerous_received_p30tip']

linkup_metrics = ['comingshortrun_count_p30tip', 'pass_count_quickpass_attempted_p30tip',
                 'pass_count_linebreak_attempted_p30tip', 'pass_count_dangerous_attempted_p30tip']

target_metrics = ['crossreceiverrun_count_p30tip', 'crossreceiverrun_count_dangerous_received_p30tip',
                 'crossreceiverrun_count_shotwithin10s_p30tip']

# Generar el dataframe con las puntuaciones
df_scored = calculate_composite_zscores(
   df_archetype,
   direct_metrics,
   linkup_metrics,
   target_metrics,
   name_g1='Direct_Composite',
   name_g2='Linkup_Composite',
   name_g3='Target_Composite'
)
4 - Clasificación y comparación de perfiles de delantero
Ya estamos listos para generar las clasificaciones de cada perfil. El siguiente código muestra cómo clasificar a los delanteros según la puntuación compuesta de Delantero directo.
# Instalar librerías
!pip install skillcornerviz
!pip install skillcorner

# Importar visualizaciones
from skillcornerviz.standard_plots import bar_plot as bar
from skillcornerviz.standard_plots import scatter_plot as scatter
from skillcornerviz.standard_plots import radar_plot as rad
# 1. Ordenar por la métrica compuesta y quedarse con los 10 primeros
top_10_direct = df_scored.sort_values('Direct_Composite', ascending=False).head(10).copy()

# 2. Crear la etiqueta personalizada del gráfico (Nombre | Posición)
top_10_direct['plot_label'] = (
   top_10_direct['player_name'] + ' | ' + top_10_direct['position_group']
)

# 3. Obtener los IDs de los 5 primeros para destacarlos en verde
top_5_ids = top_10_direct['player_id'].head(5).tolist()

# 4. Crear el gráfico de barras
fig, ax = bar.plot_bar_chart(
   df=top_10_direct,
   metric='Direct_Composite',
   label='Z-Score',
   primary_highlight_group=top_5_ids,   # Estos 5 aparecerán en verde
   primary_highlight_color='#006D00',    # Verde SkillCorner
   add_bar_values=True,
   data_point_id='player_id',
   data_point_label='plot_label',
   plot_title='Direct Striker - Top 10'
)
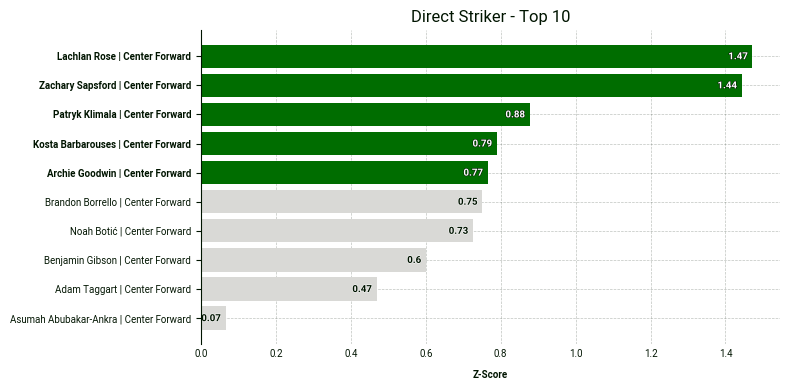
Lachlan Rose y Zachary Sapsford destacan sobre el resto, lo que indica que obtienen una clasificación especialmente alta en las métricas seleccionadas. Una de las ventajas de utilizar z-scores es que podemos observar no solo la clasificación, sino también la magnitud de las diferencias entre jugadores.
A continuación, vamos a representar los tres perfiles en un gráfico de dispersión. Copia el siguiente bloque de código para generar la visualización:
# --- 5. GRÁFICO DE DISPERSIÓN CON df_scored ---
# Identificar el Top 5 en Intensidad y Explosividad para destacarlos y contrastarlos con el volumen mediante el tamaño de la burbuja.
top_5_direct_ids = df_scored.sort_values('Direct_Composite', ascending=False).head(5)['player_id'].tolist()
top_5_linkup_ids = df_scored.sort_values('Linkup_Composite', ascending=False).head(5)['player_id'].tolist()

highlight_players = list(set(top_5_direct_ids + top_5_linkup_ids))

fig, ax = scatter.plot_scatter(
   df=df_scored,
   x_metric='Direct_Composite',
   y_metric='Linkup_Composite',
   z_metric='Target_Composite',
   data_point_id='player_id',
   primary_highlight_group=highlight_players,
   data_point_label='player_short_name',
   x_label='Direct Striker (Z-Score)',
   y_label='Link-Up Striker (Z-Score)',
   z_label='Target Man (Z-Score)',

   primary_highlight_color='#006D00',
   plot_title='Direct vs. Link-Up vs Target',
)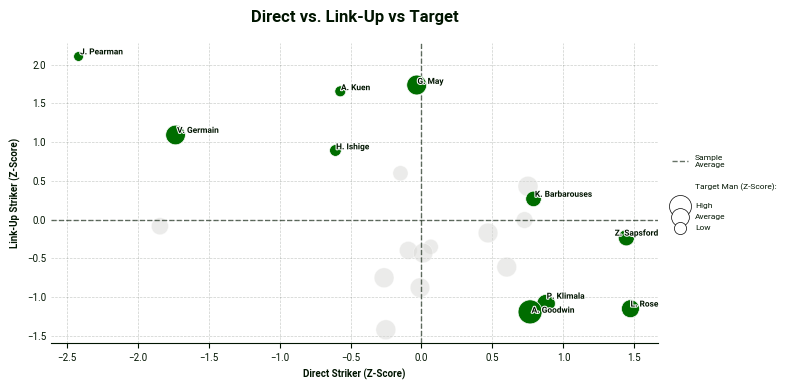
En la esquina inferior derecha encontramos a los delanteros más directos, mientras que la esquina superior izquierda la ocupan los arquetipos de delantero asociativo. El tamaño de la burbuja añade una tercera capa al análisis, lo que nos permite evaluar en qué medida los jugadores de cualquiera de los dos grupos también presentan características de delantero de referencia.
5 - Visualización de perfiles de desmarques sin balón
Tras situar a los delanteros de la A-League en los distintos perfiles, podemos validar nuestros resultados examinando sus perfiles sin balón mediante nuestro radar a medida de la SkillCorner Viz Library. El radar muestra el número de carreras de cada tipo que realiza un jugador, junto con su percentil correspondiente en comparación con la muestra.
Por ejemplo, echemos un vistazo al perfil sin balón de Valère Germain:
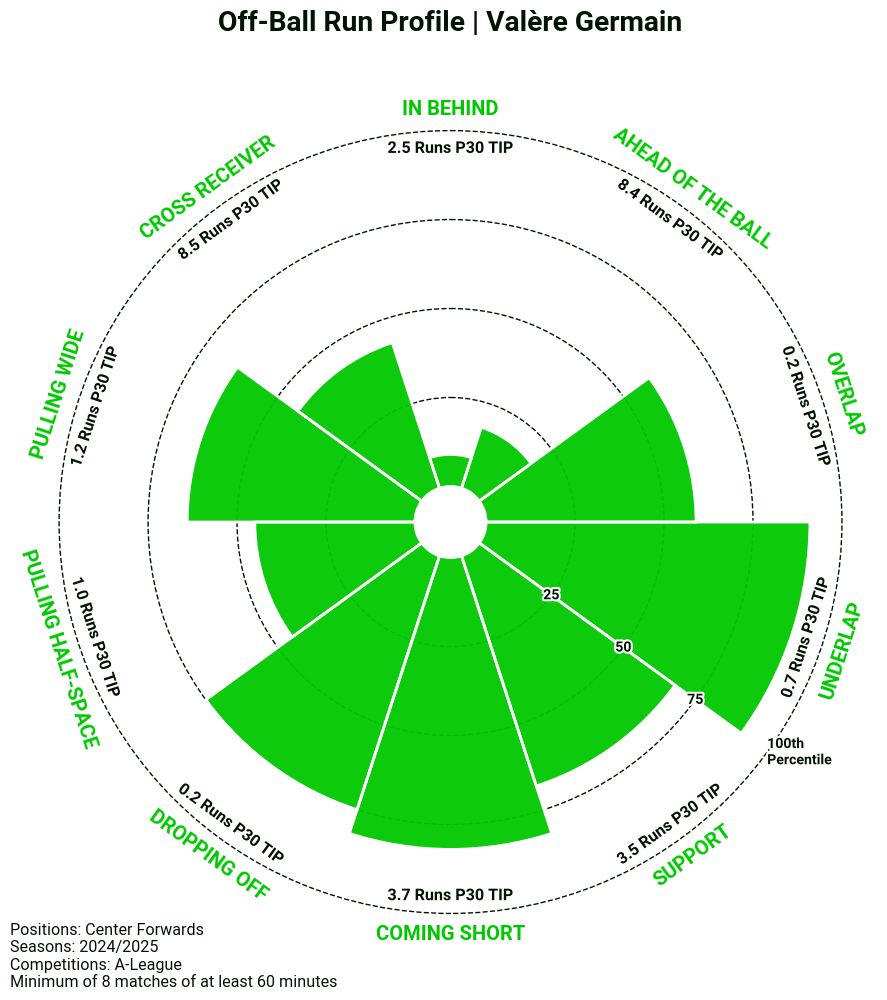
El radar encaja bien con el perfil de Germain como Delantero asociativo. Así lo demuestran sus 3,7 carreras para recibir al pie (Coming Short) por 30 TIP, que lo sitúan por encima del percentil 75.
A continuación, examinemos el radar de Archie Goodwin, que previsiblemente obtendrá valores altos en carreras más propios de un delantero tradicional, como las carreras a espaldas de la línea defensiva (In Behind) y las carreras a recibir centro (Cross Receiver), ya que ocupa una posición destacada tanto en el perfil de Delantero directo como en el perfil de Delantero de referencia.
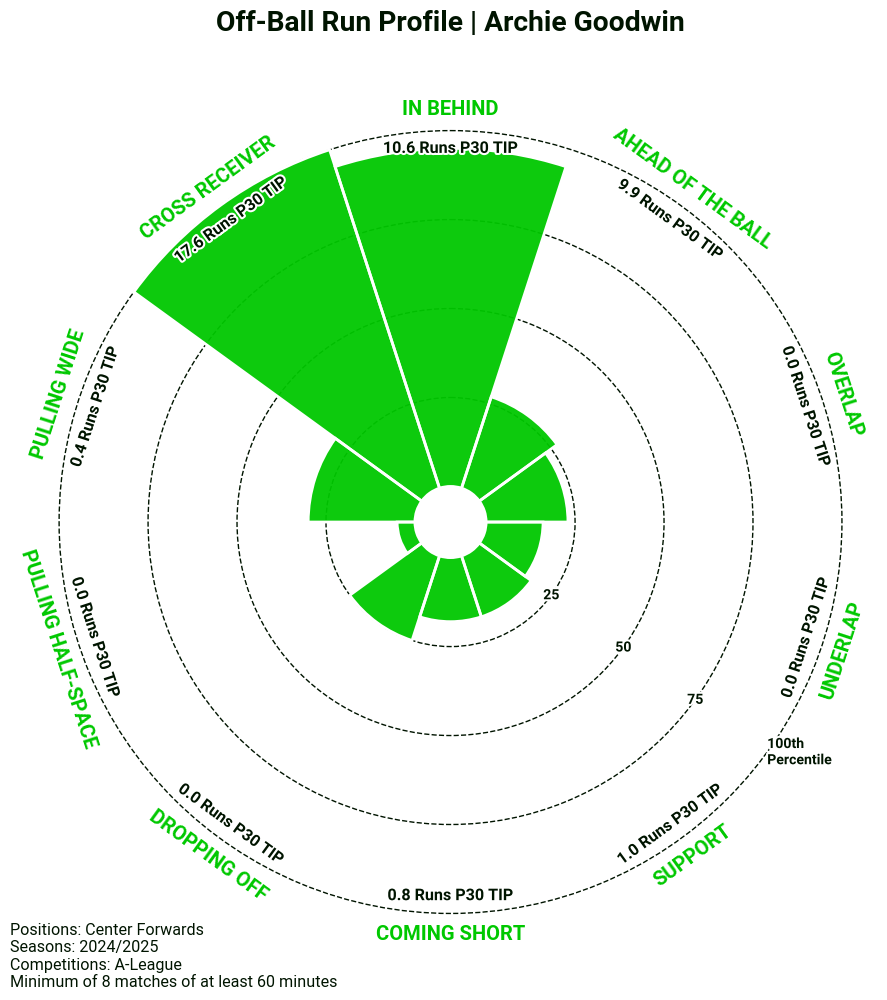
Como era de esperar, Goodwin destaca en las carreras a espaldas de la línea defensiva, con una media de 10,6 por cada 30 TIP. Sin embargo, nadie le supera en volumen de carreras a recibir centro, donde promedia 17,6 por cada 30 TIP. El jugador de 21 años fichó recientemente por el Charlotte FC de la MLS y tuvo un impacto inmediato, con tres goles en sus cinco primeros partidos.
A continuación se muestra el código para visualizar las carreras sin balón:
# Crear un nuevo dataframe, runs_df, a partir del df_filtered inicial
runs_df = df_filtered

# Mapeo de los desmarques
RUNS = {'crossreceiverrun_count_p30tip': 'Cross Receiver',
       'behindrun_count_p30tip': ' In Behind',
       'aheadoftheballrun_count_p30tip': 'Ahead Of The Ball',
       'overlaprun_count_p30tip': 'Overlap',
       'underlaprun_count_p30tip': 'Underlap',
       'supportrun_count_p30tip': 'Support',
       'comingshortrun_count_p30tip': 'Coming Short',
       'droppingoffrun_count_p30tip': 'Dropping Off',
       'pullinghalfspacerun_count_p30tip': 'Pulling Half-Space',
       'pullingwiderun_count_p30tip': 'Pulling Wide'}

# Representar el radar de desmarques sin balón de Archie Goodwin.
fig, ax = rad.plot_radar(runs_df[runs_df['position_group'] == 'Center Forward'],
                        data_point_id='player_name',
                        label='Archie Goodwin', # Qué data_point_id destacar. Si usas un nombre, utiliza player_name como data_point_id
                        plot_title='Off-Ball Run Profile | Archie Goodwin',
                        metrics=RUNS.keys(),
                        metric_labels=RUNS,
                        percentiles_precalculated=False, # Cambiado a False
                        suffix=' Runs P30 TIP',
                        filter_relevant=False, # Colorear solo los tipos de desmarque que sean importantes para tu grupo, como un grupo de usuarios

                        # Crea tu propio texto de muestra
                        positions='Center Forwards',
                        matches=8,
                        minutes=60,
                        competitions='A-League',
                        seasons='2024/2025', add_sample_info=True)
6 - Ve más allá
En esta entrega, hemos mostrado cómo combinar distintos conjuntos de datos y cómo utilizar los z-scores para crear perfiles o arquetipos.
Si quieres profundizar en estos modelos compuestos o crear tus propios arquetipos para delanteros u otros grupos posicionales, encontrarás toda la lógica en nuestro notebook de Google Colab. No dudes en adaptar las funciones para construir tus propios perfiles.
Siempre te animamos a compartir tu trabajo en redes sociales. Si lo haces, cita a SkillCorner como fuente de los datos y etiqueta nuestra cuenta correspondiente en X/Twitter o LinkedIn.